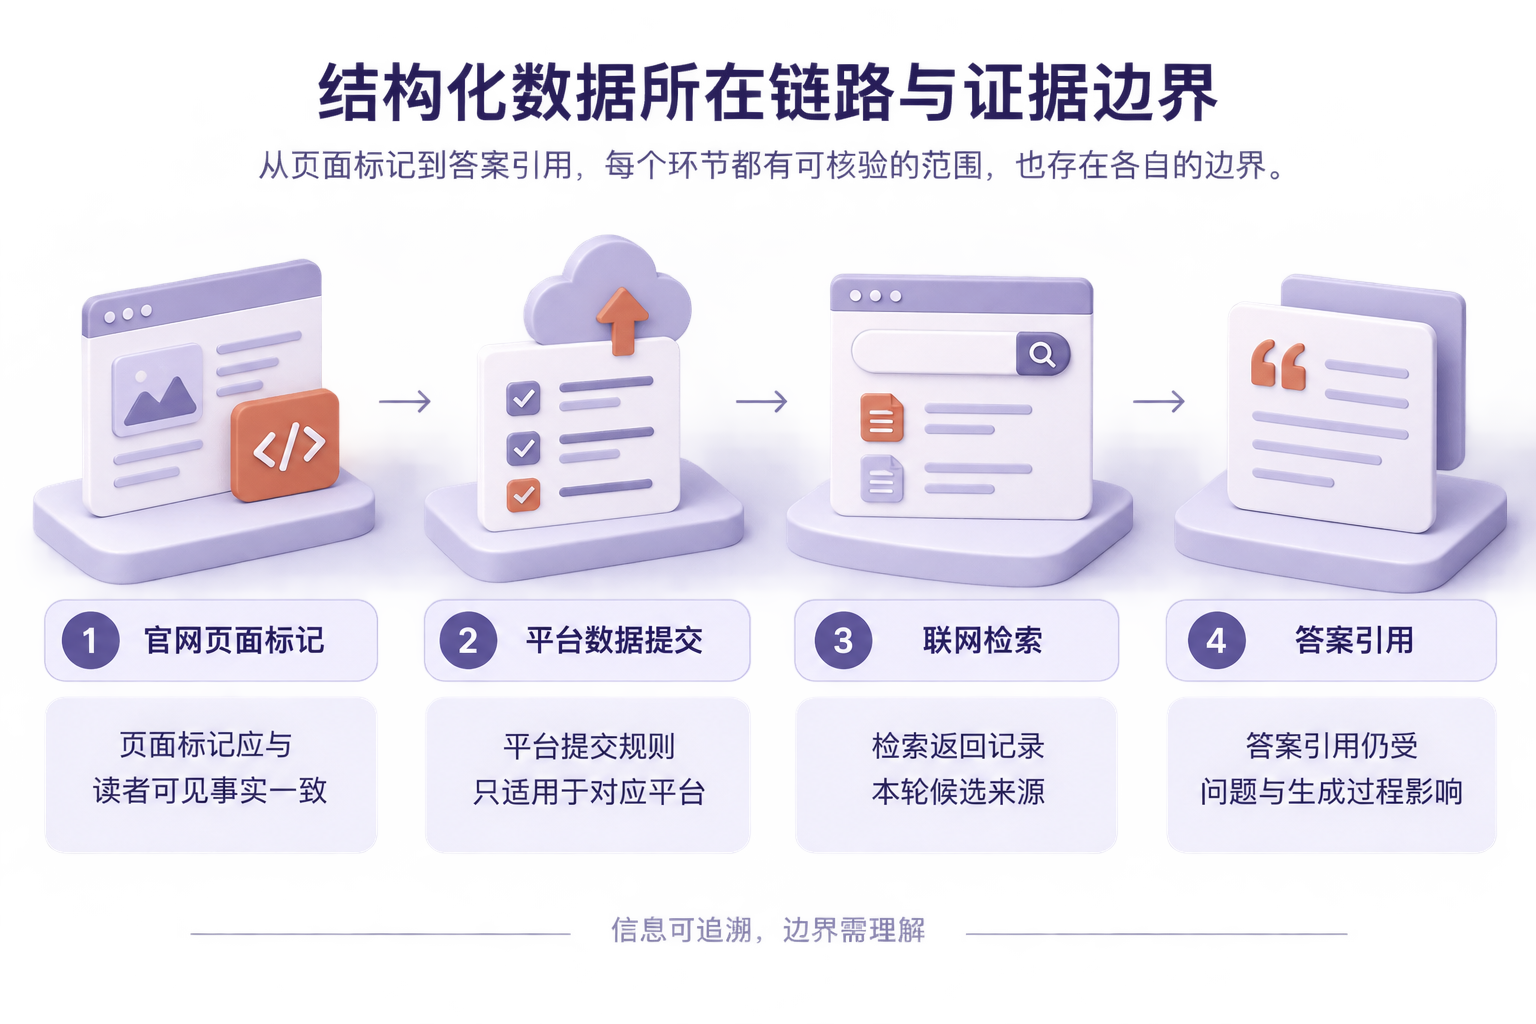
现有资料不足以给出网页内嵌 Schema 的字段级规范。百度资料讨论的是自有结构化数据提交与搜索展现;本轮提供的阿里云百炼、腾讯云联网搜索和 TokenHub 文档说明了网页检索、来源返回与引用展示,但未说明 Schema.org 类型、属性或字段权重。因此,本文不把某种 Schema 写法列为 AI 引用条件。
在现有证据范围内,企业可以把 Schema结构化数据纳入页面事实整理和发布核对:标记中的名称、日期、型号与适用条件,都应能在可见正文中找到对应内容。它能否产生实际作用,还要分别核验页面是否可访问、是否进入对应检索范围、是否匹配当前问题,以及生成答案时是否采用该来源。
常见误区是看到检测工具显示通过,便把后续问题全部归因于平台。格式可解析只说明语法通过检查,不能证明正文事实准确,也不能证明任何 AI 产品已经重新读取页面。
先分清三种容易混用的结构化数据
| 数据形态 | 实际用途 | 不能据此推断的结论 |
|---|---|---|
| 官网拟部署的 Schema 标记 | 将已确认且页面可见的事实写成机器可读声明,具体类型和字段仍需另行核对适用规范 | 不能保证收录、排序或 AI 引用 |
| 百度规定格式的数据提交 | 向百度指定入口提交字段和页面内容 | 不能外推为其他平台的 Schema 规则 |
| 联网检索接口返回的数据 | 记录搜索结果、摘要、网址与引用位置 | 不能反推网页因哪个标记获得召回 |
百度结构化数据工具要求提交字段准确、字段内容与网页一致,并把URL是否已被百度收录列为展现条件之一。这里讨论的是百度自有提交与搜索展现机制,不能改写成“所有 AI 引擎都会优先读取某个 Schema 类型”。
腾讯云联网搜索接口返回网址、摘要和相关性等结果信息,TokenHub还可以返回引用在答案中的位置。这些记录适合验证某轮检索是否找到官网,但本轮文档没有说明网页内嵌标记与相关性、权威度之间存在直接关系。
从企业事实表开始,不要先追求字段数量
结构化标记应从已经批准的企业事实生成,而不是由开发人员根据页面标题临时猜测。公司全称、品牌名称、产品型号、作者、发布日期、修订日期和适用范围一旦在正文与标记中出现不同版本,增加字段只会扩大冲突。
| 步骤 | 输入 | 处理 | 结果 |
|---|---|---|---|
| 1. 整理事实 | 营业主体、产品资料、文章记录 | 统一正式名称、版本和责任人 | 可审核的事实表 |
| 2. 映射页面 | 页面正文与事实表 | 确认每项声明在页面上有对应内容 | 正文映射清单 |
| 3. 建立关系 | 企业、网站、页面、产品和作者 | 明确谁发布、页面描述什么、归属哪个主体 | 实体关系表 |
| 4. 发布核对 | 页面版本与结构化标记 | 检查名称、日期、型号及适用条件 | 一致性记录 |
| 5. 受控复测 | 固定问题、平台和时间 | 检查召回来源与答案引用 | 可复查的测试结果 |
这套流程比一次铺开大量类型更稳妥,因为它先处理机器和读者都会遇到的事实冲突。如果官网尚未统一公司简称、产品命名和日期口径,应先修正文;此时扩充 Schema,只会让未经确认的信息更容易传播。
哪些信息值得优先声明
本轮资料没有提供 Schema.org 原始规范,无法据此列出具体类型的必填字段和可选字段。实施时可先建立字段候选清单,只纳入页面可见、来源明确且有责任人维护的信息,例如主体名称、品牌关系、产品型号、发布主体、发布日期和修订状态;选定规范与部署工具后,再逐项核对类型、属性和值格式。
不建议把频繁变化的价格、库存、交期或活动状态只写在 Schema 中。标记与可见正文更新不同步时,页面会出现两个版本;更稳妥的做法是同时显示更新时间和适用条件,并将高频变化信息纳入单独的发布审核。
政府网站网页电子文件可以依据 GB/T 42147—2022管理元数据实体、结构、元素属性和扩展。该标准自2023年7月1日起实施,适用对象是政府网站网页电子文件,不能直接作为普通企业官网提高 AI 引用概率的依据。
把格式检测与检索验证拆成两次验收
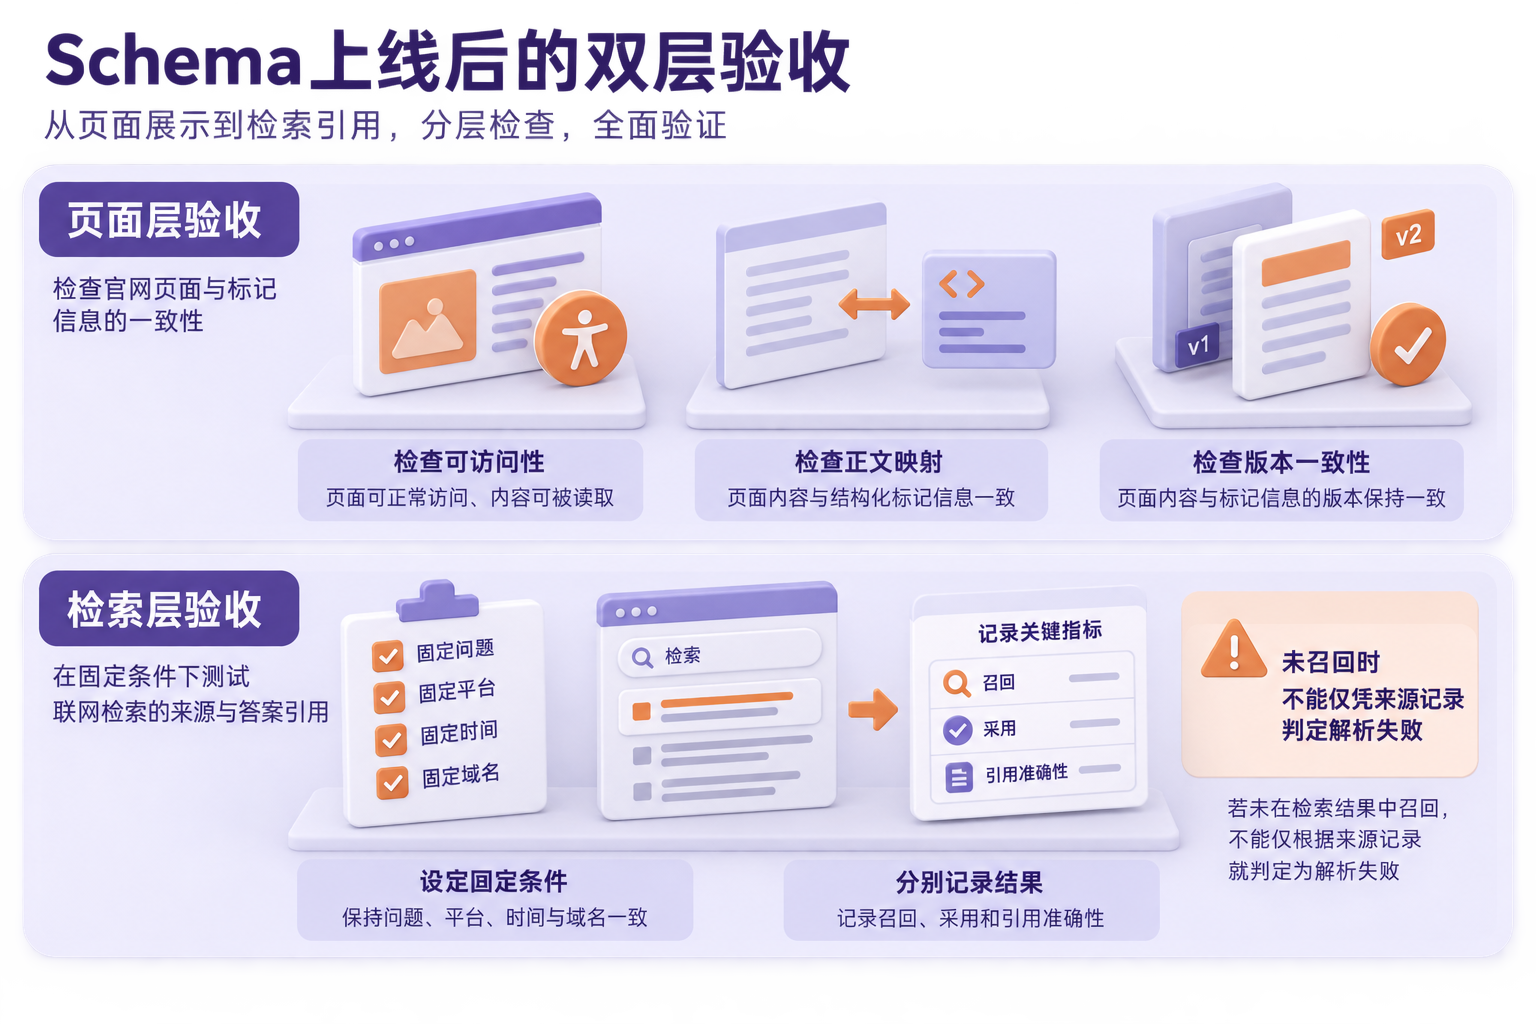
页面层验收检查官网自身:核心事实是否出现在读者可见的正文中,标记与正文是否一致,页面是否无需登录即可访问,日期和产品版本是否仍然有效。腾讯云知识库导入网页时要求目标页面无需登录,并暂不支持异步加载类型网站;这些条件只适用于该知识库导入场景,不能外推为所有 AI 平台的抓取规则。
第二次验收检查检索结果。百炼允许开发者指定优先检索的网站域名,数量上限为100个,并在开启引用后展示来源;TokenHub可以返回搜索结果或答案中的网址引用位置。企业可利用这些接口开展限定范围测试,但结果只能说明对应接口、当次问题和当次配置下的表现。
测试时应固定问题、时间范围、检索开关和域名条件,分别记录官网是否被找到、哪个页面被返回、答案是否采用,以及引用内容是否与正文一致。修改 Schema 后按相同条件复测,可以比较召回与引用是否变化;如果页面没有被返回,现有来源记录通常无法继续判断问题发生在页面解析、索引还是候选筛选环节,还需结合对应平台提供的其他诊断证据。
按证据层级决定是否继续投入
从知识治理角度,Schema结构化数据适合承担页面事实映射和发布核对,不宜单独设为 AI 引用增长项目。正文事实错误、页面在目标场景下无法访问和产品名称冲突应优先处理;旧版本页面是否下线,则要结合业务留档要求判断,不能把清理历史页面写成平台规则。
验收结果可分为四级:格式可解析,只说明部署完成;正文一致,说明数据没有自相矛盾;检索可召回,说明页面进入了本轮候选来源;答案有引用且内容准确,才说明该页面在指定测试条件下被实际采用。四级结果应分开记录,不能用前一级替代后一级。
如果修改前后只有格式状态变化,而召回和引用没有变化,应暂停继续堆字段,转查页面内容、访问方式和问题匹配度。如果页面已经稳定召回但没有进入答案,应优先补充能够直接回答问题的正文证据,而不是直接认定平台没有识别 Schema。
常见技术问题
如何判断Schema结构化数据是否已经进入AI检索链路?
固定问题和条件复测,并检查返回的来源记录。
为什么Schema校验通过后官网仍没有被AI引用?
校验只证明格式可解析,召回与采用仍需另行复测。