参数套错最难排查的情况,是请求成功但约束没有生效
企业为了减少接入成本,常把一套 OpenAI 风格参数直接发送给不同模型。字段能够完成序列化,甚至接口返回成功,都不能证明平台按同一种语义执行了这些参数。DeepSeek Responses API 不支持 previous_response_id、conversation、store、metadata 和 background,parallel_tool_calls、max_tool_calls 等字段则会被忽略。火山方舟的工具调用示例使用 store:true 保存响应,并通过 previous_response_id 关联后续请求。
这会产生两类故障。显性故障通常返回 400,调用链可以直接定位问题;隐性故障仍会返回内容,但会话没有延续、工具数量限制没有执行,或者输出预算与业务预期不同。后一类问题更危险,因为监控系统可能把 HTTP 成功当成调用成功。
本文所称豆包侧,仅指资料明确展示的火山方舟 Responses API 接入行为,不据此推断豆包应用端的状态管理、检索或答案生成机制。需要解决的问题也不是让两个平台表现完全一致,而是让企业在请求发出前知道哪些能力能够对应、哪些只能近似转换、哪些必须拒绝。
统一接口之前,先拆开四类容易混用的语义
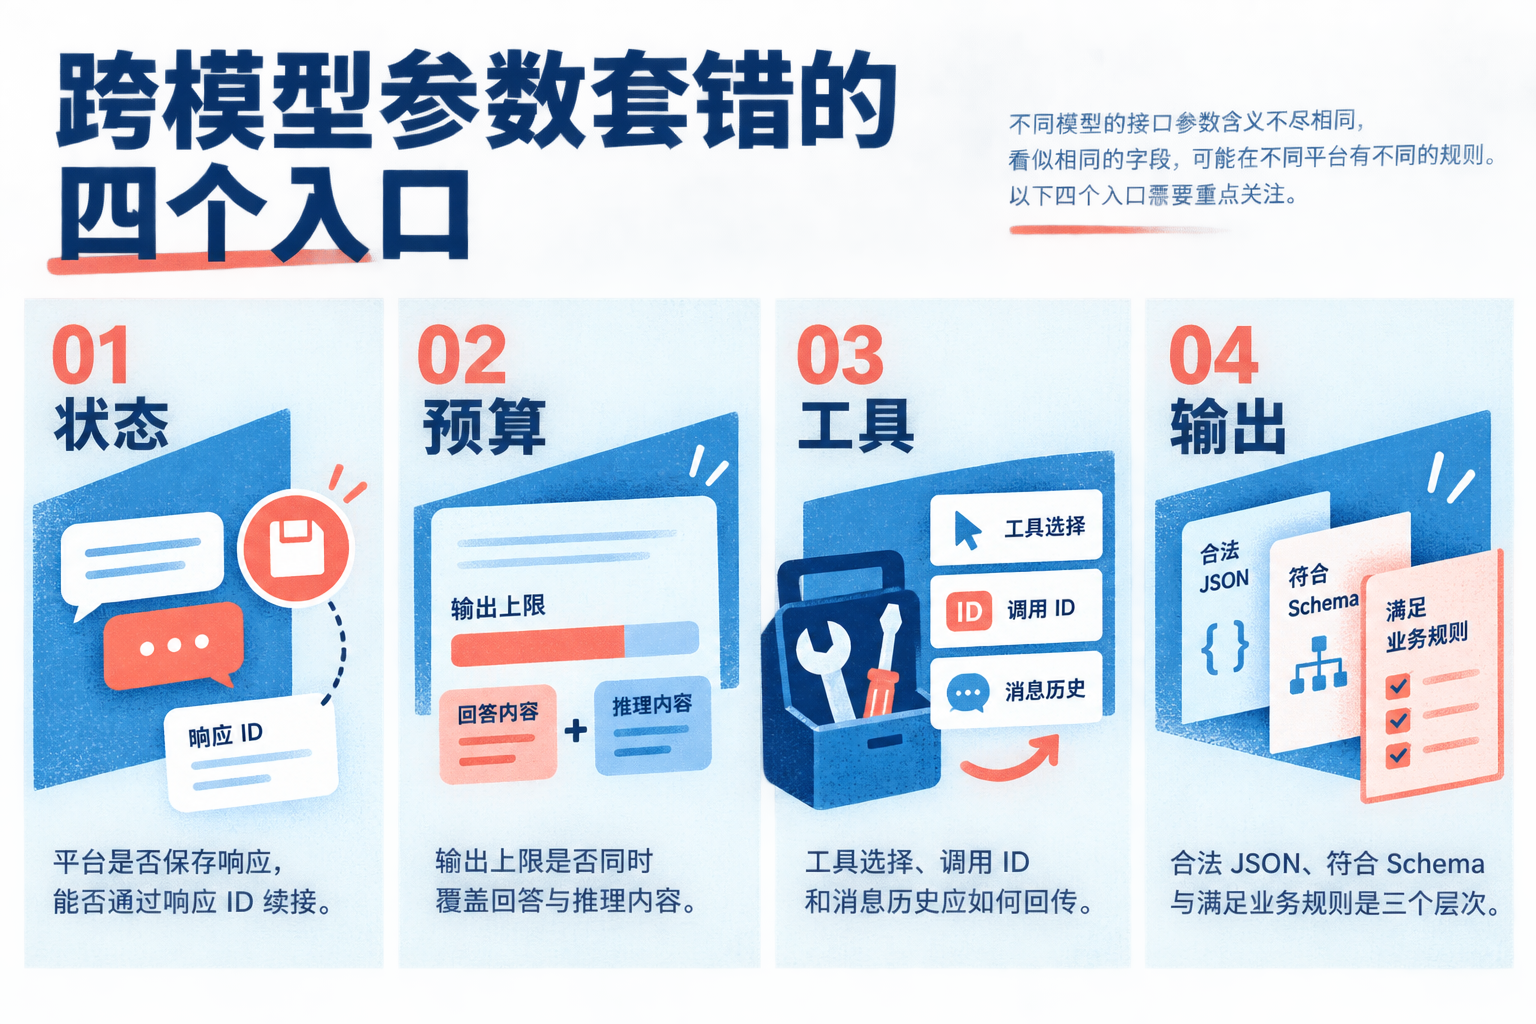
第一类是状态歧义。火山方舟示例显示,调用方可以使用响应 ID 关联前序请求;DeepSeek Responses API 则是无状态接口,不支持 previous_response_id 和 conversation。输入超过上下文窗口时,该接口会返回 400,而不是自动截断。企业如果把 previous_response_id 当成跨平台会话标准,切换模型后可能直接丢失上下文。
第二类是预算歧义。火山方舟将 max_output_tokens 定义为模型输出上限,额度同时覆盖最终回答和推理内容。DeepSeek Responses API 也接受 max_output_tokens,但现有资料不足以证明两边采用完全相同的预算核算方式。DeepSeek 的 Oh My Pi 接入指南又使用 max_tokens,而非 max_completion_tokens,说明参数名称还会随端点和集成框架发生变化。同名字段不能直接视为等价,异名字段也不能只靠名称判断是否需要映射。
第三类是工具歧义。在 Oh My Pi 接入指南所述配置中,DeepSeek 思考模式不接受 tool_choice;回传工具调用历史时,需要保留 reasoning_content,并确保 assistant 消息的 content 不为空。火山方舟示例则通过 call_id 与 function_call_output 继续第二轮调用。中间件如果只统一 tools 字段,却没有保留平台要求的消息结构,第一轮可能成功,第二轮仍会失败。
第四类是输出约束歧义。提示词要求返回 JSON,只能提高格式符合概率;JSON Mode 主要解决语法合法性;Schema 可以继续约束字段、类型和枚举。即使结果通过 Schema 校验,也不能证明金额范围、日期先后、产品型号、权限边界等业务关系正确。结构化输出因此至少需要格式校验和业务规则校验两个层次。
底层网关应统一业务意图,不应强行统一供应商字段
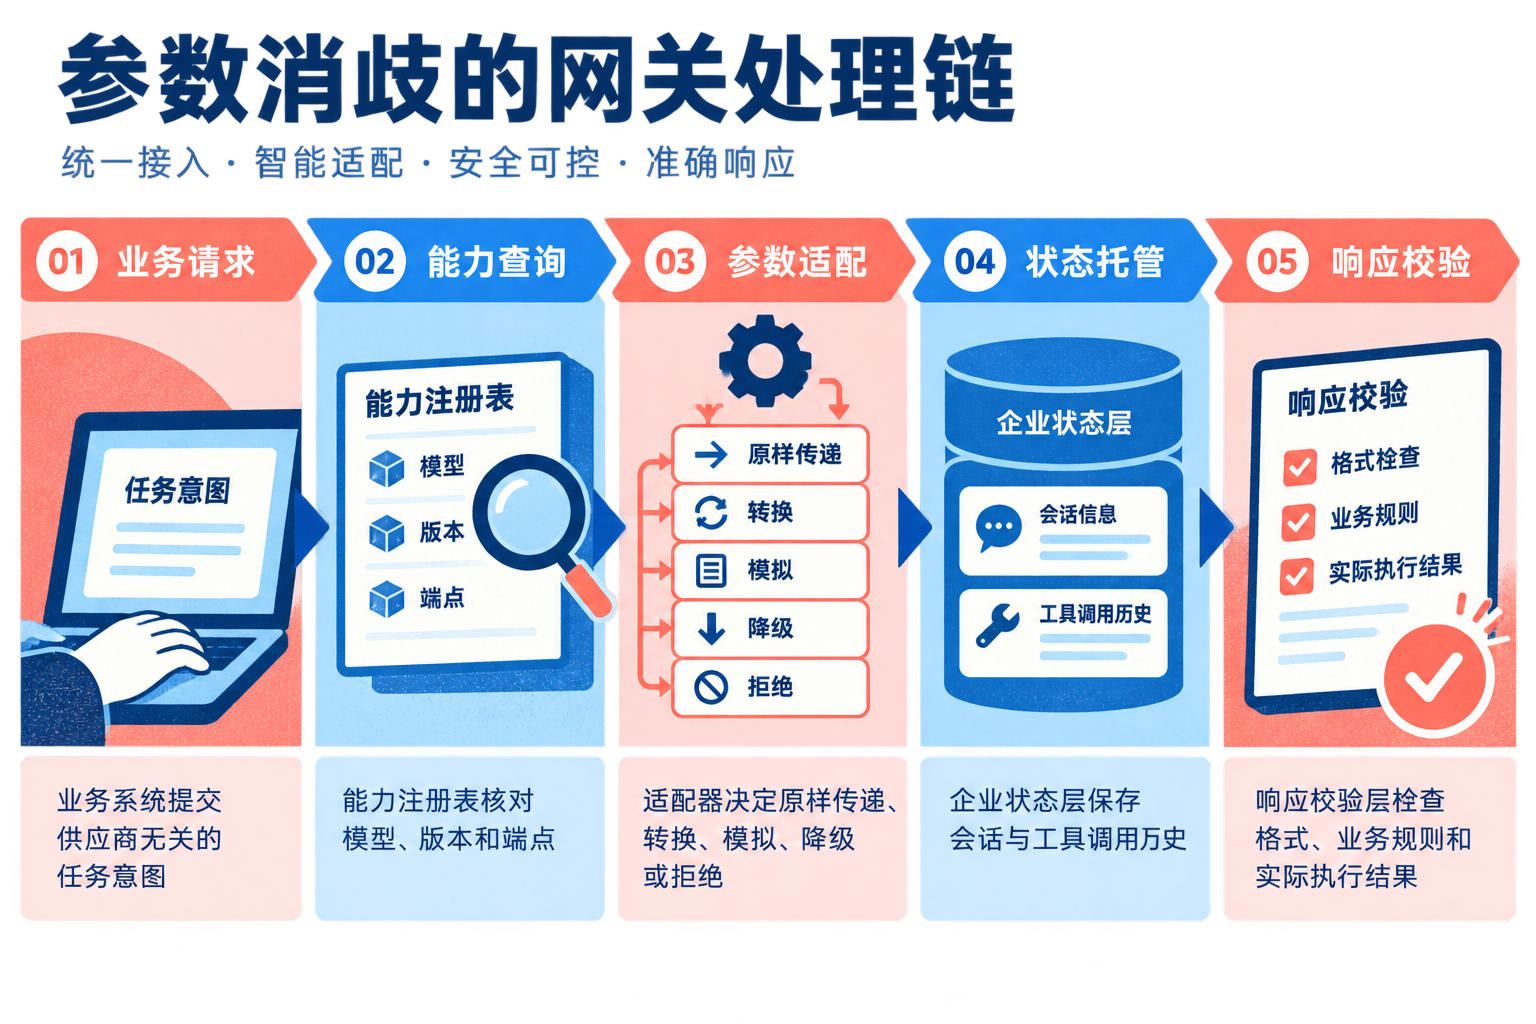
网关需要先定义一套与供应商无关的请求契约。业务系统提交的应是“是否需要连续会话”“允许使用哪些工具”“输出预算上限”“推理强度”“是否允许并行调用”“结构化约束等级”和“超长输入处理方式”等业务意图,而不是 previous_response_id、reasoning_content 或某个平台的模型别名。
统一请求契约不代表每项意图都能无损翻译。适配器应先查询模型能力注册表,再决定原样传递、字段转换、网关模拟、受控降级或拒绝请求。注册表至少要记录供应商、端点、模型名称、实际版本、参数状态、转换规则和验证时间。参数状态也不能只有支持与不支持,还应区分原生支持、需要转换、接收但忽略、由网关模拟和明确拒绝。
模型别名同样属于契约的一部分。DeepSeek 更新日志显示,2026 年 9 月 10 日其标准调用名称调整为 deepseek-flash,部分旧名称虽然仍能提交,但会被路由到新的实际模型。若业务代码只记录请求时填写的别名,不记录最终模型和路由结果,升级后就难以解释效果、价格或参数行为为何发生变化。
会话状态更适合由企业侧保存。供应商提供的响应 ID 可以作为开发便利或性能优化手段,但不宜成为唯一历史记录。企业状态层应保存经过授权的用户消息、工具调用、工具结果、必要的推理字段和裁剪记录。切换模型时,网关重新组装符合目标端点要求的上下文,而不是要求另一平台识别原有供应商的会话标识。
静默丢弃只能用于低风险字段,不能成为默认兼容策略
LiteLLM 提供 drop_params 机制。目标模型不支持某个 OpenAI 参数时,系统可以删除该字段,也可以查询支持列表或指定需要额外删除的参数。这类功能适合处理兼容问题,却不宜在生产环境中不加区分地全局开启。
原因是不同端点可能同时存在“明确报错”和“接收后忽略”两种行为。DeepSeek Responses API 会忽略 parallel_tool_calls、max_tool_calls 等字段。如果网关又静默删除其他不兼容参数,调用虽然可以完成,团队却无法从响应状态判断工具限制、状态保存或预算控制是否真正执行。
更稳妥的编辑判断是:凡是影响权限、自动执行、会话连续性、金额处理、输出边界和结构化约束的字段,应默认拒绝或要求调用方显式接受降级;日志标签、追踪信息以及不影响业务正确性的采样选项,才适合受控丢弃。证据支持这一判断,是因为 HTTP 成功只能证明端点返回了响应,无法证明每项控制均已生效。对读者的直接影响是,网关验收标准不能停留在“能返回文本”,还要核对关键约束的实际行为。
这项策略并非适用于所有场景。一次性摘要、低风险演示和允许尽力而为的内部工具,可以通过显式配置启用宽松模式;采购决策、对外问答、自动调用工具或涉及权限和金额的流程,应使用严格模式。无论采用哪种模式,日志都应记录模型、端点、原始字段、处理动作、降级原因和最终生效的配置。
契约测试要验证参数行为,不能只验证是否返回内容
上线前应按“供应商、模型、版本、端点”建立测试矩阵。先发送一个明确不支持的字段,确认网关会拒绝、转换还是记录后丢弃;再执行至少两轮工具调用,检查调用 ID、工具结果、必要的推理字段和 assistant 消息结构是否完整;随后提交接近或超过上下文限制的输入,验证系统会按既定策略裁剪、压缩或拒绝,而不是临时采用不可追踪的处理方式。
结构化输出需要分别测试语法、Schema 和业务规则。测试样本不能只有正常结果,还应包括缺失必填字段、错误枚举、金额越界、日期顺序错误和型号关系冲突。只有三层校验都通过,结果才适合进入后续业务流程。
还应专门测试“接口成功但约束未生效”的情况。例如,设置工具调用数量限制后,检查实际调用次数;声明需要连续会话后,验证第二轮是否包含必要历史;设置输出预算后,核对响应中的使用情况和截断表现。无法直接观测的机制,不应在验收记录中写成已经确认,只能标记为待验证假设或供应商声明。
模型升级、端点变化或别名路由调整后,应重新运行同一批测试。最终记录至少包括请求使用的模型别名、实际模型版本、被转换字段、被忽略字段、会话保存位置、原始供应商响应和失败时的降级路径。参数消歧的目标不是抹平平台差异,而是让差异在执行前可识别、执行中可记录、执行后可复查。