企业排查官网缺席AI答案时,常见错误是拿一个系统的证据解释另一个系统:百度蜘蛛能够读取页面,便认定所有AI产品都能找到它;某个平台没有展示官网,又立即修改robots.txt。两种判断都越过了证据边界。
腾讯云TokenHub和阿里云百炼公开的是各自联网检索接口的触发方式、查询处理和来源记录。百度抓取诊断显示的则是Baiduspider实际取得的页面内容,两类资料不能互相替代,更不能用于推断豆包、DeepSeek或Kimi消费端的内部机制。
这套联网检索与百度抓取排查应先恢复可观察证据,再决定是否改站。原因是搜索未触发、官网未被召回和页面访问异常需要不同处理;一开始扩大抓取权限,既不能证明故障原因,还可能增加非公开资源暴露风险。
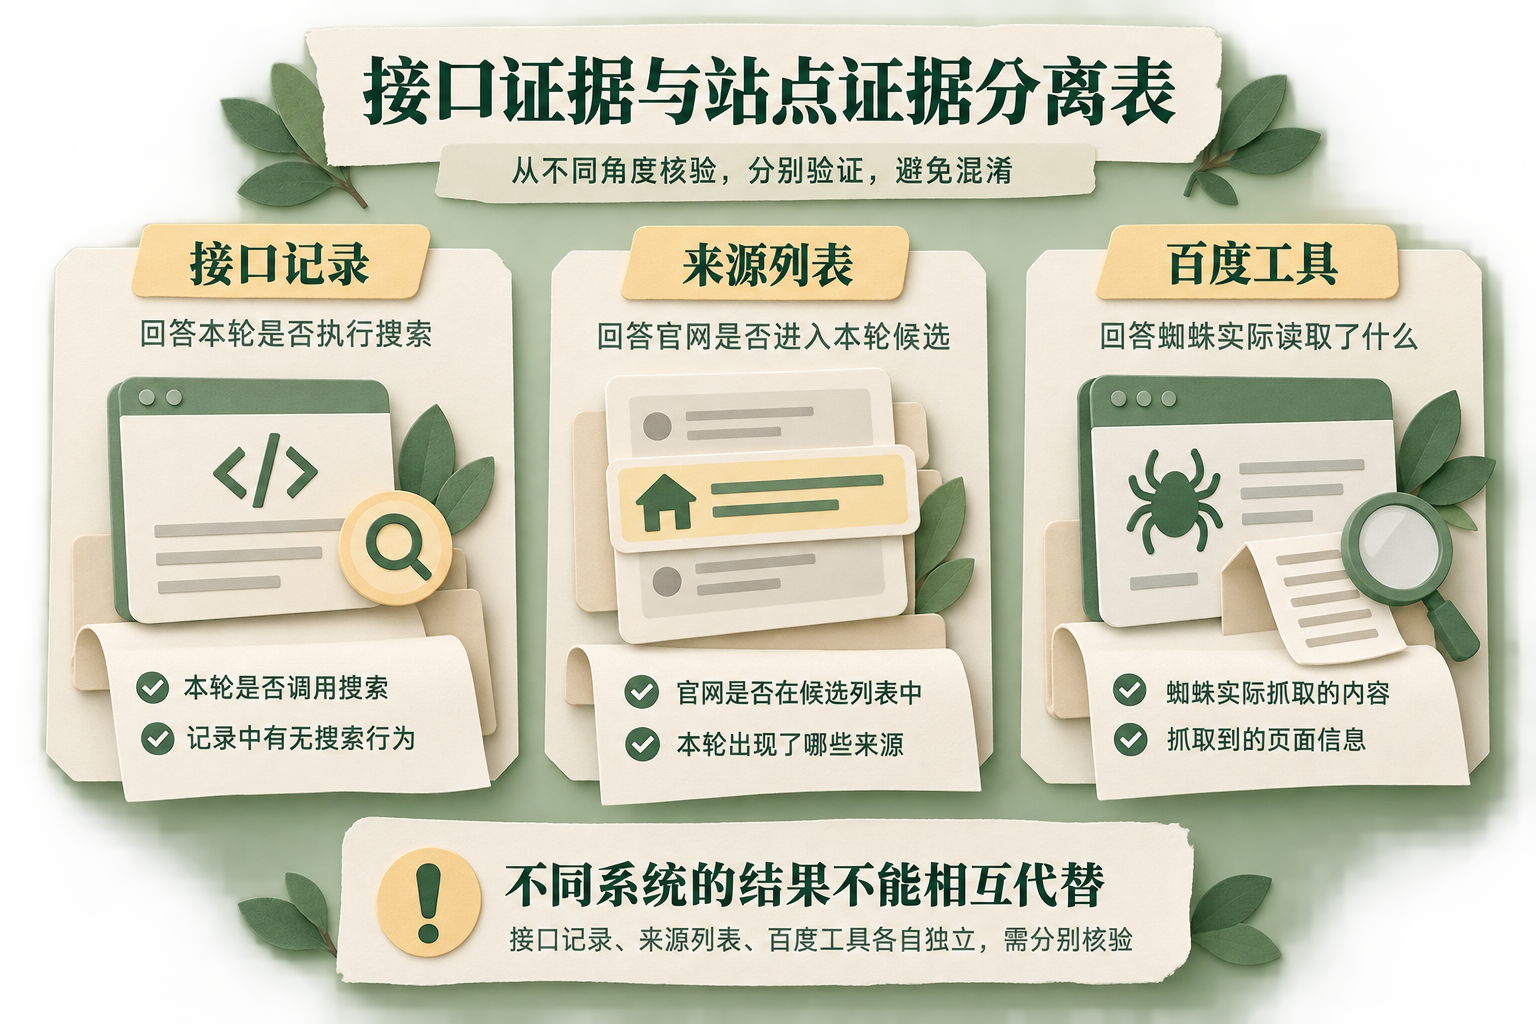
先把接口证据和站点证据分开
排查记录至少应分成两张表:一张记录目标产品是否执行搜索、使用了什么查询以及返回哪些来源;另一张记录Baiduspider能否发现并读取目标页面。没有对应记录的平台,只能形成测试线索,不能把推测写成平台结论。
| 当前证据 | 能够判断什么 | 不能据此判断什么 | 后续检查 |
|---|---|---|---|
| 接口支持并完整返回调用记录,但本轮没有搜索调用 | 本轮未执行联网搜索 | 网站一定无法抓取 | 调整问题或在该接口中启用检索 |
| 已执行搜索但来源没有官网 | 官网未进入本轮返回列表 | 页面尚未被任何系统收录 | 核对查询词、地域、时间范围和检索版本 |
| 来源列表已有官网 | 页面进入本轮候选来源 | 回答一定采用官网内容 | 保存来源位置并核对生成答案 |
| 百度提交记录成功 | 链接已提交给百度处理 | 页面已经进入索引 | 查看抓取与索引状态 |
| 抓取诊断正文异常 | 百度蜘蛛实际读取内容与预期不符 | 其他AI平台存在相同故障 | 修复跳转、验证或页面输出后复诊 |
这张表的作用不是建立一条所有平台通用的抓取链,而是防止证据串用。只有在同一产品、同一时间和同一问题下取得的搜索调用与来源记录,才适合比较前后变化。
接口侧先查本轮到底搜了什么
腾讯云TokenHub允许模型自主判断是否需要联网搜索,并可返回搜索调用和引用信息。搜索词、版本、地域及上下文大小可能改变召回结果,因此复盘时不能只保存生成回答,还要保存实际查询和来源列表。
阿里云百炼的千问联网检索Agent可以改写查询、选择检索源,并支持时间范围、强制检索及指定网站。开发者可指定不超过100个网站域名并优先从中获取信息;该能力适合排查百炼接口,不代表其他产品具有同样的控制项。
如果自动检索没有触发,而强制检索后官网进入来源列表,优先处理问题表达与检索触发条件,不必先改网站。如果两种方式都执行了搜索,官网仍未进入返回列表,再检查实际搜索词、地域和时间范围是否覆盖目标页面。
站点侧只回答百度蜘蛛看到了什么
百度将网站出现在搜索结果中的过程分为爬虫发现、索引入库和搜索展示。普通收录工具可以缩短链接被发现的时间,但提交成功不等于页面已经进入索引,也不能证明它会被其他AI产品采用。
Baiduspider访问网站前会检查对应协议、域名和端口根目录下的robots.txt。核验时应查看目标公开页面是否被User-agent、目录前缀、Allow、Disallow或通配符规则误伤,而不是因为一次答案缺席就放开整个站点。
百度抓取诊断面向已验证站点,每个站点每周可使用70次,结果只展示百度蜘蛛可见的前200KB内容。应把诊断结果与浏览器正文对照,检查蜘蛛取得的是有效内容,还是登录页、验证码、空模板、跳转页或错误提示。
修复是否有效,要由同条件复测判断
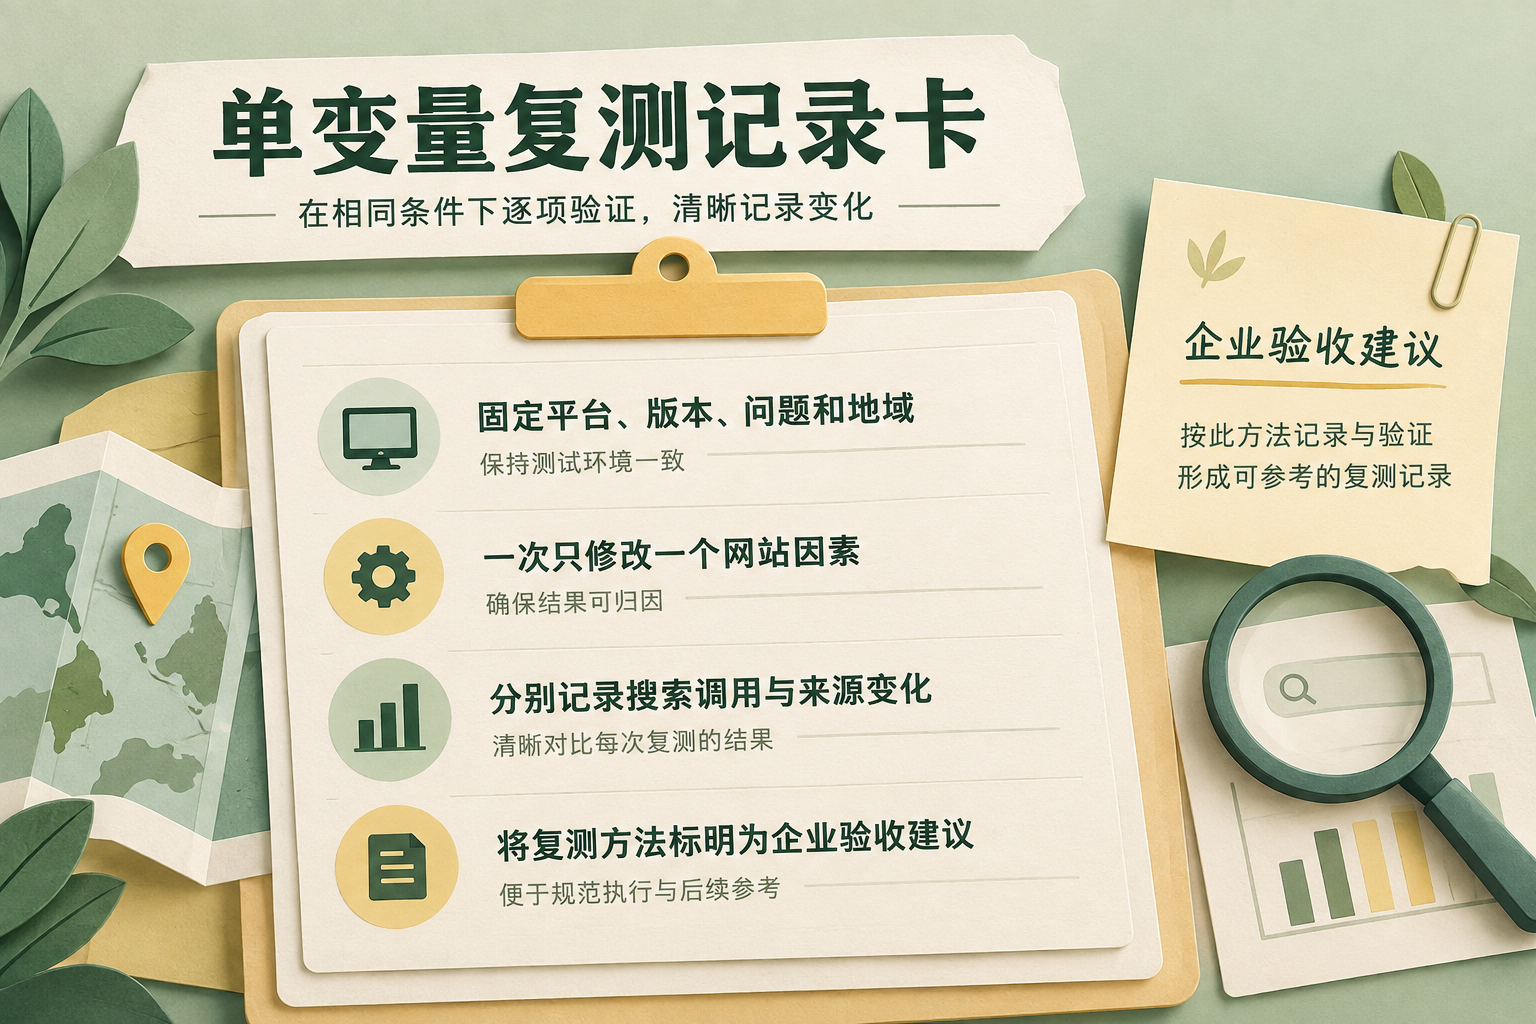
修复网站后使用原平台、原问题、原地域和相近时间再次测试,是本文建议的验收方法,不是百度抓取诊断的官方规则。固定条件可以减少查询改写、检索版本和地域差异对结果的干扰。
每轮只改变一个因素:先处理已经确认的页面访问异常;页面恢复后再观察来源列表;官网能够稳定进入来源后,才检查正文是否完整回答问题。不要同时改robots、标题、正文和网站地图,否则即使结果变化,也无法判断是哪项修改产生影响。
若官网持续进入来源列表却没有进入回答,继续重复提交网址的价值有限。此时更应检查页面是否直接给出产品名称、参数条件、发布日期和适用范围;不过,来源是否被答案采用仍由对应产品决定,页面改进不能构成展示保证。
回滚与纠错SOP
- 冻结现场并备份证据。 测试负责人保存平台名称、产品版本、问题文本、测试时间、搜索调用和来源列表;运维负责人备份robots.txt、网站地图、访问控制策略及目标页面。通过标准是修改前状态可以恢复,接口证据与站点证据分别留存。
- 只处理已确认的访问异常。 运维负责人针对误封目录、异常跳转、验证码、空模板或错误页面做限定范围调整,不开放后台、客户资料和非公开文件。通过标准是普通用户与Baiduspider均能取得目标公开正文,原有限制资源仍不可访问。
- 复查发现、索引与页面内容。 站点管理员按百度工具要求提交新增或修订链接,内容负责人核对标题、正文事实、发布日期和适用条件。保留提交记录和旧页面快照;通过标准是抓取诊断内容与当前页面一致,但不把提交成功写成已经收录。
- 按原条件复测并决定回滚。 测试负责人使用相同平台、问题和地域复查搜索调用、来源列表及回答。若修改造成公开范围扩大、页面异常或受限资源暴露,立即恢复备份;若网站访问已正常但官网仍未进入来源,则回到接口侧核对查询条件,不继续无依据地放宽抓取权限。
常见技术问题
如何判断应继续核对检索条件还是检查网站?
先核对查询、地域、时间和版本;条件覆盖目标页后再检查站点。
为什么百度链接提交成功仍不能证明页面已经收录?
提交只帮助发现链接,百度仍会按自身标准处理。