官网没有出现在文心答案中,不能直接判断为“文心没有抓取”。页面可能尚未被百度蜘蛛访问,也可能已经被访问但未建立索引;即使页面进入搜索候选,仍可能没有被当前问题召回,或在答案生成时未被采用。
百度文心助手官方页面列出了深度搜索和溯源校验能力,但没有公开消费者产品使用的爬虫名称、抓取周期、索引库结构或引用排序公式。千帆文档公开的是企业应用可调用的搜索能力,不能据此断言消费者版文心采用完全相同的接口和权重。
企业需要判断页面停在访问、发现、索引、检索还是引用阶段。把这些状态合并成一个“收录率”,容易让内容团队持续改稿,却没有修复访问受阻、版本冲突或问题匹配不足等真正故障。
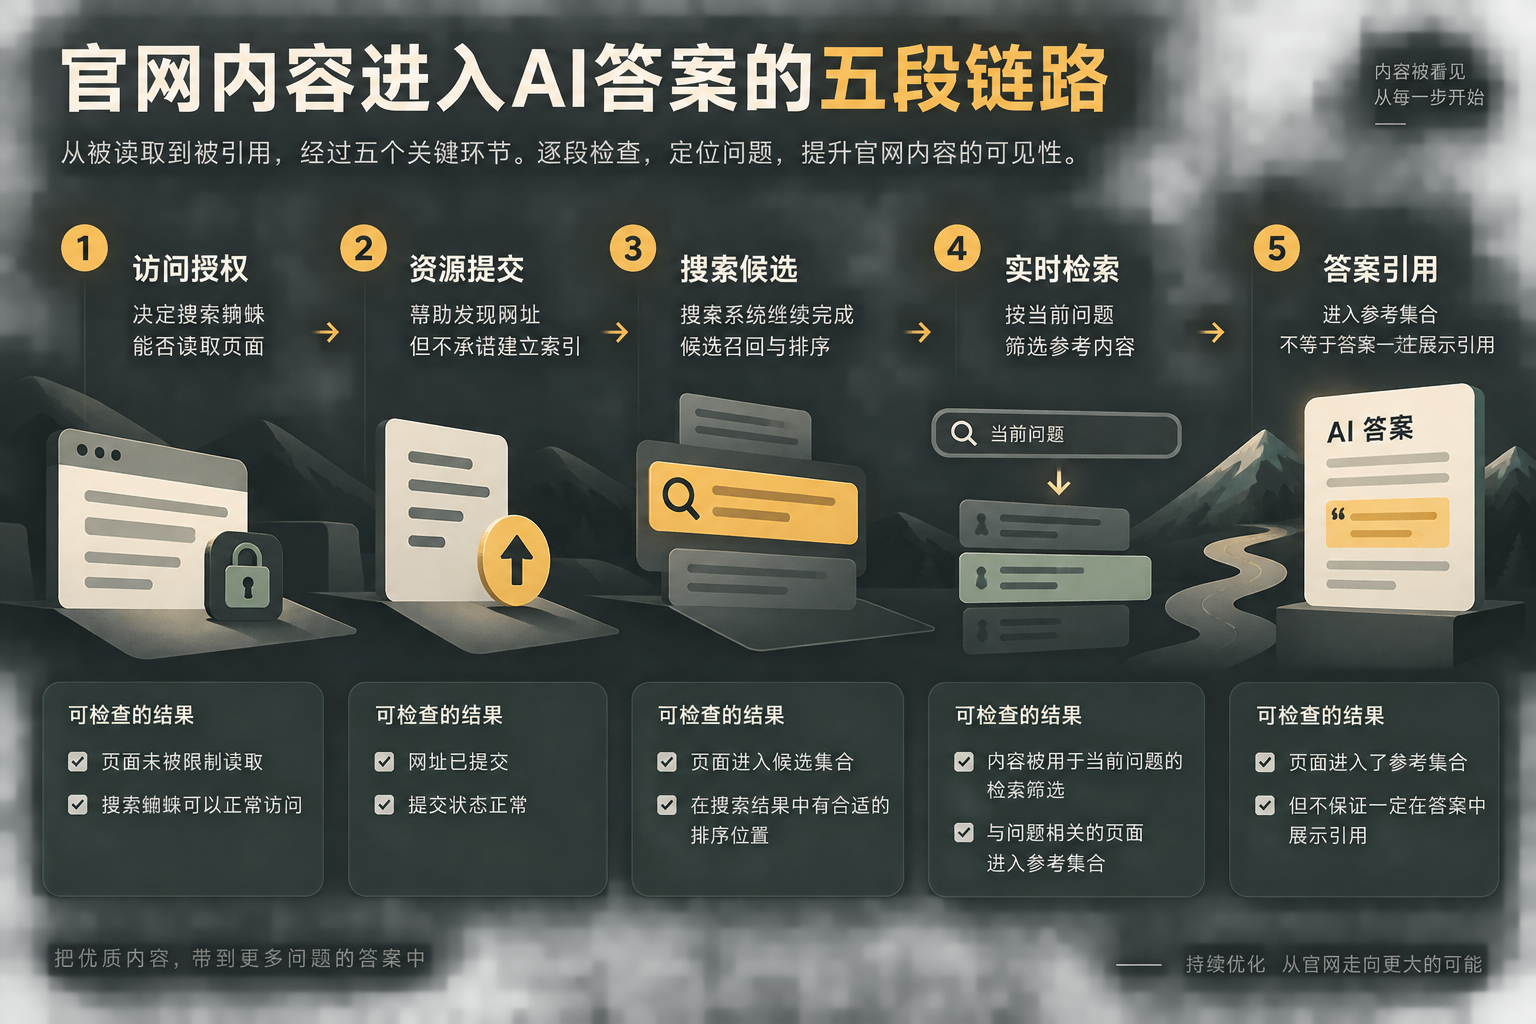
把官网进入答案的过程拆成五段
| 环节 | 输入与处理 | 可检查结果 |
|---|---|---|
| 访问授权 | 根据页面地址及robots规则判断路径能否访问 | 服务器日志、抓取诊断、页面响应状态 |
| 资源发现 | 通过站点地图、资源提交和站内链接发现网址 | 提交记录、抓取记录、异常提示 |
| 搜索候选 | 结合文本匹配、语义召回和排序处理页面 | 索引量、搜索结果、摘要版本 |
| 实时检索 | 根据问题及站点、时间等条件筛选参考内容 | 返回网页、相关性信息、来源范围 |
| 答案引用 | 模型根据候选证据组织回答并决定是否展示来源 | 答案正文、引用角标、溯源页面 |
这五段是一套基于百度现有官方工具和千帆文档建立的诊断模型,不是百度公开确认的消费者版文心内部架构。它的作用是给每种判断配置检查对象,避免把“没有引用”直接解释成“没有抓取”。
排查顺序应从访问与发现开始。被robots规则排除或长期无法正常响应的页面,缺少进入后续处理的基本条件;页面已有传统索引记录,也不足以单独证明会被当前问题召回并用于答案。千帆文档确认企业接口可执行实时全网搜索,但没有说明该能力与百度传统索引的底层关系,因此不能据此判断消费者版文心存在独立入口。
资源提交只帮助发现,不能替代索引与AI采用
百度2018年9月13日发布的robots协议升级公告,将robots.txt说明为站点与搜索蜘蛛沟通的渠道。它决定特定路径是否允许抓取;文件不存在或内容为空,通常表示允许访问,但开放访问不等于页面一定会被抓取。
百度搜索资源平台2021年11月5日发布的使用指南说明,资源提交可通过推送接口、站点地图和手动提交进行。这些方式用于帮助搜索系统发现网址,不代表页面一定被访问或建立索引。
百度2021年公开的两篇搜索论文还表明,页面进入候选处理后,可能继续经历文本匹配、基于ERNIE的语义召回、摘要抽取和排序。页面与查询使用不同措辞,不代表一定无法匹配;反复堆叠查询词也不能证明页面会排在靠前位置。
这些论文反映的是百度搜索当时公开的工程方法,不能作为2026年消费者版文心的现行引用公式。它们可以支持企业改善主题表达和页面完整性,却不能支持固定权重、稳定排名或引用保证。
千帆文档能确认什么,又不能外推什么
千帆AI搜索文档将企业应用的处理过程描述为实时全网搜索与大模型总结的结合。应用可以选择不搜索、强制搜索或由模型判断是否搜索,也可以限定站点、发布时间、来源范围和资源类型,并将企业自有知识与公开搜索结果共同提供给模型。
2026年7月9日更新的联网搜索文档说明,调用方可以控制是否返回溯源信息和引用角标。检索文献数量与提供给模型总结的参考文献数量,公开范围均为一至二十八;增加数量会改变候选覆盖范围,但不能据此推断引用质量会同比提高。
2026年8月11日发布的智能搜索生成高性能版文档还提供相关性得分和权威性得分,取值范围为零至一。文档没有公开评分公式、采用阈值或信号权重,因此这些字段适合同一接口内的对照测试,不应改写成官网通用评分。
由此可以提出一个有边界的判断:页面已被百度搜索发现,仍不能证明它会出现在文心答案中。当前问题可能没有触发搜索,页面可能未进入参考集合,模型也可能选择其他证据;只有一次问答截图时,无法区分这些原因。
用受控测试定位内容停在哪一段
官网内容抓取诊断按访问授权、资源发现、索引版本、实时检索和引用返回逐段核验;百度资源提交不保证抓取或建索引,千帆联网搜索公开的检索文献与参考文献数量范围均为一至二十八条。
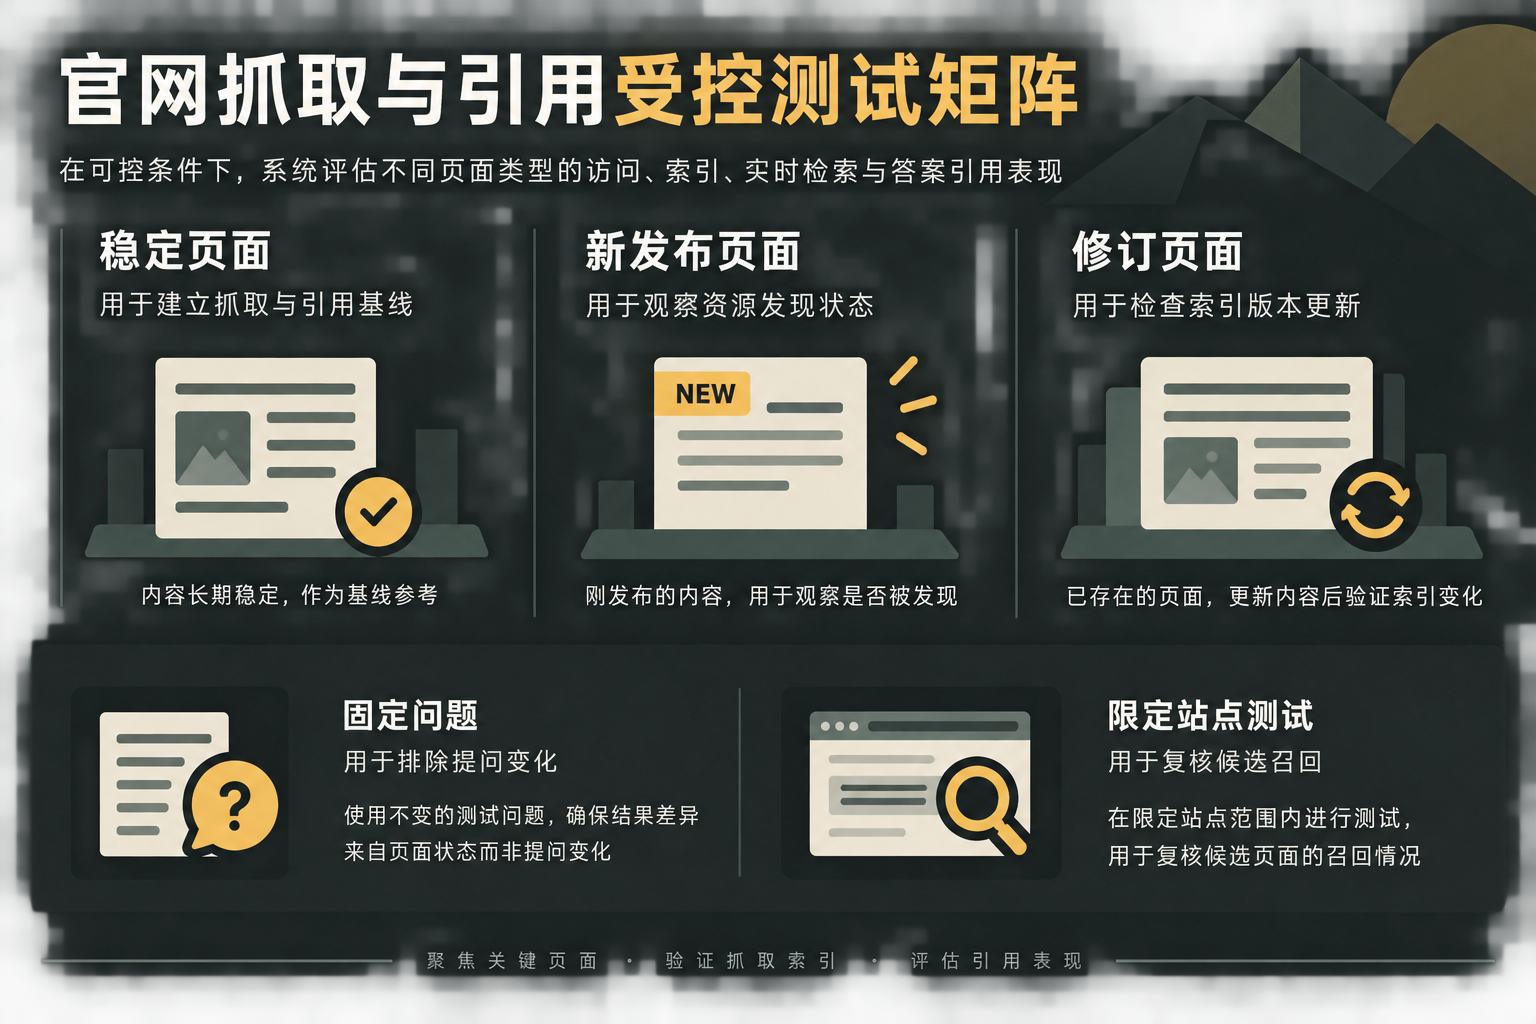
- 固定页面与版本。 分别选择长期稳定页面、新发布页面和近期修订页面,记录标题、发布日期、正文版本及规范地址。测试期间不要同时更换路径、标题和核心事实,以免无法判断变化来源。
- 核查访问与发现。 检查robots规则、页面响应、站内链接、站点地图和提交记录,再结合服务器日志及抓取诊断,确认百度蜘蛛是否实际访问。
- 核查索引版本。 搜索完整标题和能够区分版本的事实句,观察搜索结果展示的是现行内容还是历史摘要。若仍出现旧版本,应先检查重复网址、失效页面和规范地址关系。
- 执行引用对照。 固定问题、测试日期和产品版本,记录消费者产品是否搜索、是否返回来源及引用了哪些页面。具备千帆环境时,可通过限定站点、强制搜索和返回溯源信息,复核页面能否进入候选。
- 按证据归因。 没有抓取记录时处理访问与发现;能够搜索但限定站点检索不到时,检查页面有效性和问题匹配;已经进入参考集合却未用于回答时,再核对页面是否直接提供了回答所需证据。
工程验收不应以一次品牌提及或一次未引用作为结论。至少保留页面版本、抓取记录、固定问题、测试时间、来源列表和答案差异;消费者版文心与千帆测试结果应分开记录,避免把企业接口的可控条件误当成消费者产品的公开机制。
常见技术问题
如何判断官网内容没有被文心引用是卡在抓取还是答案生成?
先查访问、抓取和索引,再用固定问题核对来源返回。
为什么向百度提交网址后仍不能证明文心会引用该页面?
提交只帮助发现资源,不保证抓取、建索引或答案引用。