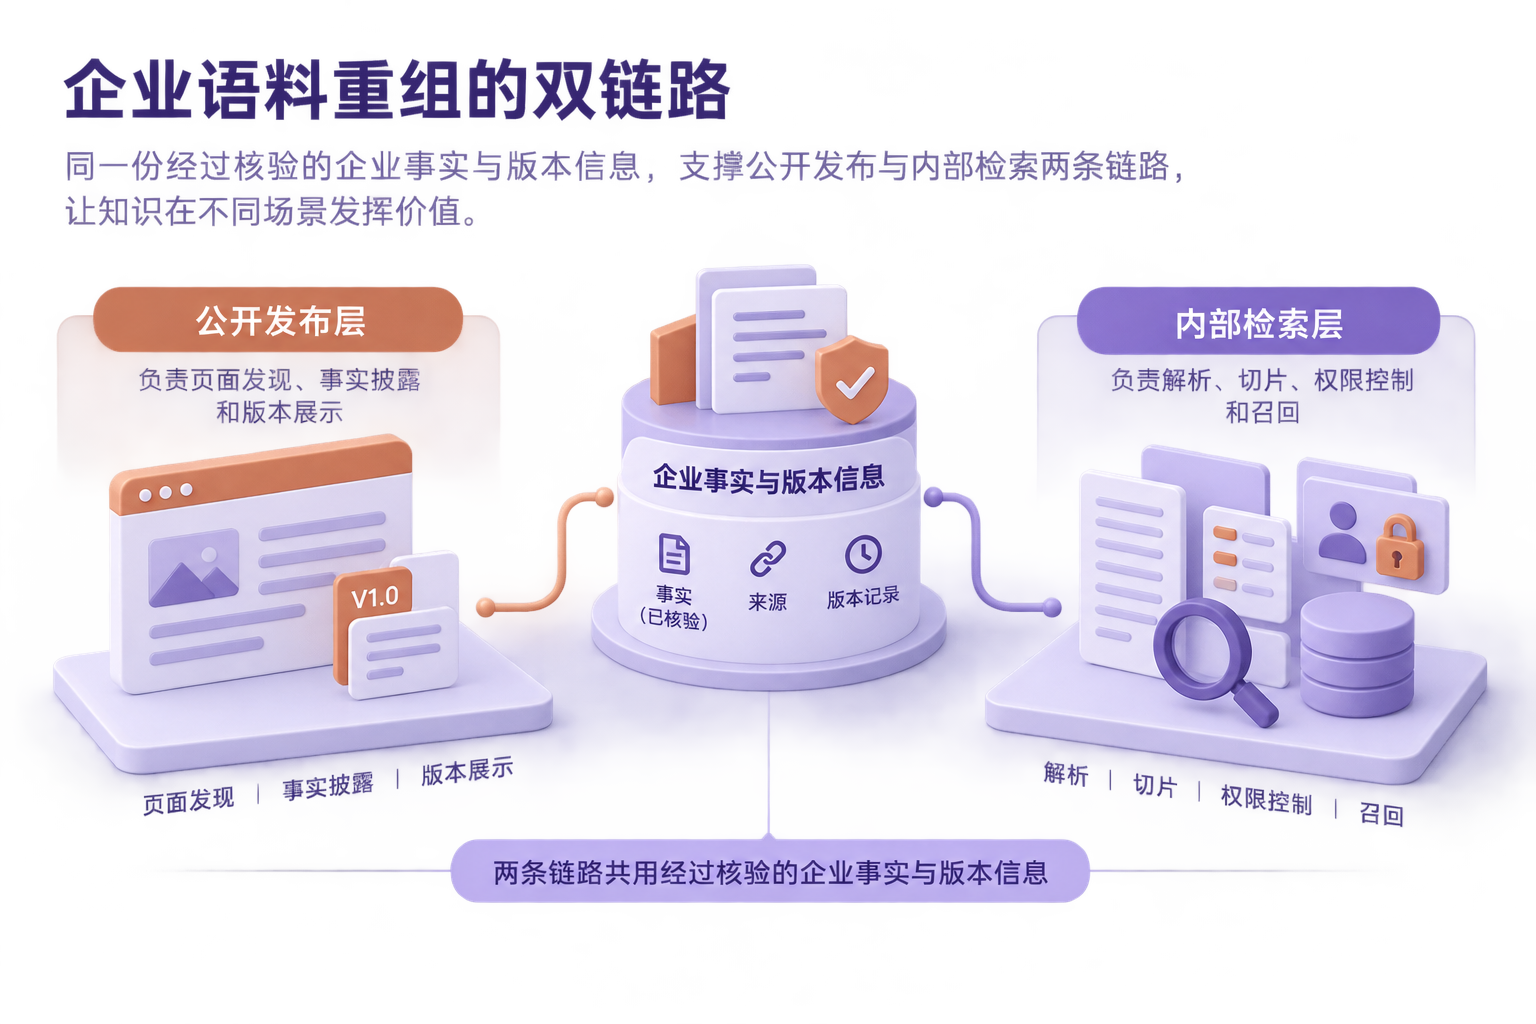
大模型语料重组不应先统一文件格式或切片长度。应先判断知识用于公开发现还是内部检索,以及用户要查询字段还是理解带条件的完整说明。
“面向大模型抓取”包含两条链路:官网依赖页面访问与站点发现,内部知识库依赖主动导入、解析和索引。百度搜索资源平台说明,Sitemap和提交工具只帮助发现页面,不保证抓取、索引或排名,更不能证明页面已进入大模型答案。
百度千帆、火山方舟和讯飞星火均支持多种资产输入,但可上传不等于适合检索。公开发布层与内部检索层应分开设计,并共用经过核验的事实与版本记录。
应优先做好知识职责分离。统一格式便于处理,却可能破坏表格字段、章节关系和图片证据;保留多种形态虽然增加治理工作,但能减少条件丢失和跨版本误用。
先按知识用途选择形态,不按现有文件后缀分类
同一份产品手册可以生成公开产品页、内部切片和参数表。选择形态时,应检查信息是否需要字段筛选、是否依赖上下文、版面关系能否丢失,以及更新责任能否定位。
| 知识形态 | 适合承载的内容 | 重组重点 | 主要风险 |
|---|---|---|---|
| 公开网页 | 产品能力、适用范围、服务边界、现行说明 | 稳定地址、明确标题、更新时间和主体关系 | 页面可发现不代表一定被索引或采用 |
| 叙述型文档 | 技术手册、报告、制度、操作说明 | 保留章节层级、条件、例外和前后文 | 按固定长度硬切会拆散结论与限制条件 |
| 结构化表格 | 型号参数、问答记录、政策条目、状态数据 | 固定字段,并区分检索字段与筛选字段 | 单元格缺少单位、对象或条件时容易套错 |
| 图片与音频 | 图纸、铭牌、流程图、演示讲解、会议录音 | OCR或语音解析后保留原资产定位 | 识别结果可能破坏表格关系或专业符号 |
| 事实关系层 | 实体名称、产品关系、版本替代和证据来源 | 关联主张、来源、时间和适用对象 | 推断关系不能替代原始文件 |
火山方舟区分结构化与非结构化资产,并允许字段分别参与向量检索和条件过滤。因此,需要按型号、地区或状态筛选的资料适合采用字段表;依赖章节解释的制度则应保留上下文。
GB/T 42131—2022覆盖知识提取、存储、挖掘与推断等环节,但属于推荐性国家标准,也未规定企业必须采用的切片长度。截至2026年8月7日,知识图谱与大规模预训练模型集成项目仍在起草,不能作为现行要求。
让资料从文件库存流转为可核验知识单元
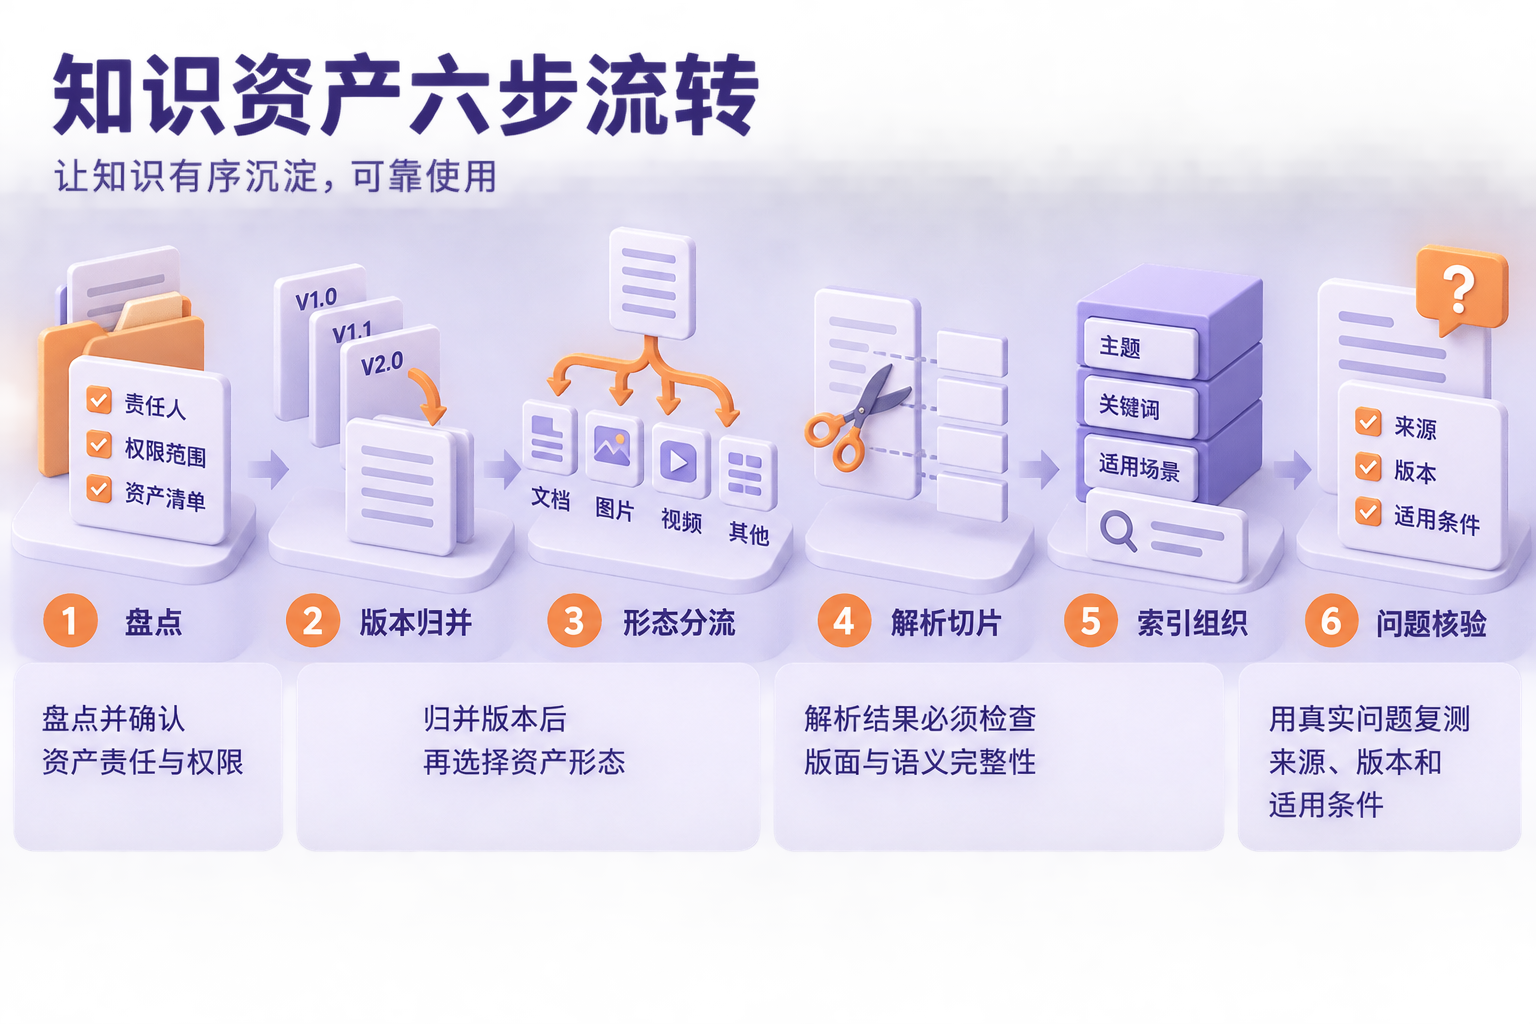
语料重组应先确认现行来源和业务问题,再决定结构、切片与索引方式。这样才能区分召回失败源于资料、解析还是检索配置。
| 流转步骤 | 输入 | 处理 | 结果 |
|---|---|---|---|
| 1. 资产盘点 | 官网、手册、表格、图片、录音 | 记录主体、责任人、日期、权限和当前状态 | 可追踪的资产目录 |
| 2. 版本归并 | 同主题的历史稿与现行稿 | 标记替代、失效、冲突和待确认关系 | 有效版本集合 |
| 3. 形态分流 | 已确认的有效资料 | 按公开网页、文档、表格和多媒体分类 | 对应的处理路线 |
| 4. 解析与切片 | 原始文件及版面结构 | 恢复标题、段落、表格、图片和阅读顺序 | 语义完整的候选切片 |
| 5. 索引组织 | 切片、字段及实体关系 | 配置全文、语义、混合检索或条件过滤 | 可召回的知识单元 |
| 6. 问题核验 | 真实业务问题与正确答案 | 检查来源、版本、适用条件和引用位置 | 可复测的检索记录 |
PDF需要检查解析后的阅读顺序。火山引擎可通过版面分析和OCR恢复正文、表格及图片结构,但跨栏、合并单元格、图注和扫描件仍要抽查;得到文本不等于保留了原有事实关系。
事实关系层可记录型号归属和版本替代,但必须回指原始来源。遇到冲突时应标记待核验或限制回答,不能让推断覆盖正式文件。
切片长度应服从语义依赖,不能照抄平台上限
大模型语料重组方案按内容依赖选择资产形态:高信息密度内容可采用约200—500字符切片,强上下文内容采用约800—1000字符,并通过主张、来源、版本和适用条件核验检索结果,降低参数错配与更新遗漏。
上述范围来自火山方舟文档知识问答指南中的示例建议,不是豆包、DeepSeek或其他平台共同确认的采用阈值。实际长度还会受到标题是否随切片保留、表格能否独立解释、问题粒度和召回方式影响,验收时应比较语义完整性与错误召回,而不是只检查字符数。
平台配置不能直接横向换算。百度千帆整文件模式单切片上限为15万字,火山引擎提供多档长度,讯飞星火区分处理、切分和向量化状态。这些配置只说明输入处理能力,不证明切片越长越好,也不是网页抓取规则。
反复通过DeepSeek API分析同一长文档时,可将固定内容置于前部,以利用前缀缓存。缓存可能未命中或被清理,只影响调用组织与成本,不能替代版本治理和检索测试。
用对照样本完成选型,不用一次性全库转换
实施时可选择一个产品系列或一项制度建立对照样本,同时保留原文档、字段表、语义切片和公开说明页。再用采购、技术、售后与合规人员的真实问题,检查来源以及对象、条件、单位和版本是否完整。
验收时检查四项:是否命中现行资料,切片能否独立解释,筛选是否混淆产品,源文件删除或替换后旧切片是否仍可召回。保留失败样本,用于区分资料缺失、解析错误、索引遗漏和回答越界。
需要公开发现的事实进入稳定网页;需要筛选的固定字段进入结构化表格;依赖章节逻辑的内容保留文档结构;图片和音频仅在证据无法由文本替代时单独解析;跨资料关系再进入事实关系层。
资料少、更新慢且主要依靠人工查阅时,先做好版本、标题和目录即可。只有跨文件冲突、实体混淆或组合查询已造成检索失败,才需要增加关系层与混合检索。
常见技术问题
如何判断产品资料应该拆成表格还是文档切片?
字段固定且需要筛选时用表格,依赖上下文时保留文档结构。
为什么提交Sitemap仍不能证明页面已被采用?
提交只帮助发现站点,不保证页面被抓取、索引或获得排名。