打开很多企业的官网后台,经常会看到一组令人焦虑的数据:页面收录量还在涨,关键词排在首页的数量没跌多少,但自然搜索的点击量和咨询量却断崖式下滑。
原因并不复杂:用户的搜索行为被重塑了,中间的“点击”环节被 AI 直接截胡。
在过去,用户带着需求搜索,要在十几个网页之间跳进跳出比对信息;现在,无论是在国内用 Kimi、DeepSeek、豆包,还是在海外用 SearchGPT、Perplexity,用户只要抛出一个复杂问题(比如“预算20万以内、支持本地私有化部署的中型企业ERP怎么选?”),AI 就会在几秒内给出一份结构清晰的选型建议,并直接指名道姓推荐几家服务商。
这就是行业常说的零点击搜索(Zero-Click Search)普及化。用户拿完答案就走,根本不会点进搜索结果列表。传统 SEO 争的是“页面排名”,而今天企业必须争的是“成为大模型生成答案时的权威论据与首推品牌”。
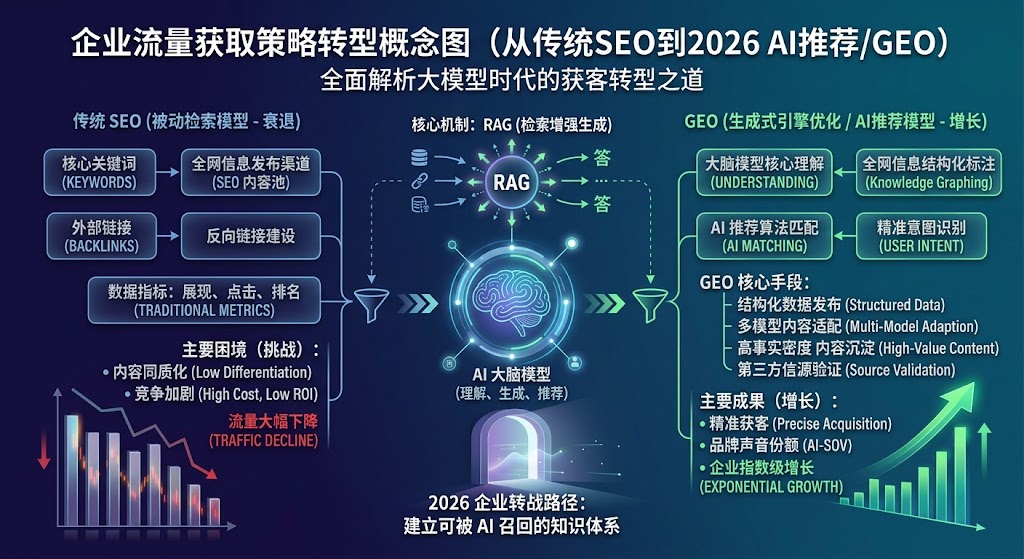
这场转变催生了 GEO(Generative Engine Optimization,生成式引擎优化)。
底层逻辑剧变:SEO 与 GEO 的本质对照
想要落地 GEO,必须先打破对传统 SEO 的路径依赖。两者从算法机制到评判标准截然不同:
| 维度 | 传统 SEO(搜索引擎优化) | 2026 企业 GEO(生成式引擎优化) |
| 核心机制 | 爬虫抓取 + 网页权重 + 关键词频率匹配 | 大模型语义理解 + 向量检索(RAG)+ 事实论证召回 |
| 争夺阵地 | 搜索结果列表页前10条(SERP 蓝链) | AI 综合回答中的段落、引用角标与首推建议 |
| 内容偏好 | 词频合规、文章字数、页面排版、内链密集 | 高事实密度、清晰参数、客观对比、结构化数据 |
| 外链逻辑 | 外链权重传导(PageRank 体系) | 全网第三方信源一致性与交叉验证 |
| 衡量指标 | 展现量、点击率(CTR)、关键词排名 | 品牌引用率(Citation Rate)、AI声音份额(AI-SOV) |
简单来说:SEO 解决的是“让机器搜到你”,GEO 解决的是“让大模型信任并推荐你”。
2026 企业转战 GEO 的五步标准化落地流程
企业做 GEO 不需要把现有的数字资产推倒重来,而是要按照大语言模型的“理解、提取、验证、引用”逻辑,分阶段实施体系改造。
第一阶段:企业数字实体与事实库对齐(Entity Alignment)
大模型回答问题时最忌讳“事实模糊”。很多企业官网充斥着“业内领先”、“卓越解决方案”等形容词,但在 AI 看来,这类没有参数、没有定义的主观表述属于无效噪音,甚至会导致模型产生事实幻觉。
-
清理主观虚词,建立品牌事实卡片(Fact Sheets): 梳理企业核心信息,包括统一的品牌全称、成立年份、业务范畴、产品型号、核心技术参数、服务客群、典型交付场景。确保这些信息在全网所有官方渠道字字统一。
-
代码级实体标记(Schema.org): 全面部署结构化数据标记。使用
Organization、SoftwareApplication、Product、TechArticle等标准 Schema 格式,把产品价格区间、功能清单、FAQ 等数据明明白白标注在网页代码层,方便 AI 爬虫精准提取实体属性。 -
规范化知识文档: 编写面向机器友好的白皮书和技术文档,以“问题-定义-机制-数据指标”的标准逻辑组织排版。
第二阶段:基于用户真实提问搭建“场景化 Prompt 词库”
传统 SEO 关注的是零散的关键词(如“上海 CRM”),而 AI 时代的搜索几乎全是长句甚至多轮对话(如“50人外贸团队,需要对接海外社交渠道,哪款CRM性价比高?”)。
-
抓取四类典型意图 Prompt:
-
对比型: “A产品和B产品在权限管理上有何区别?”
-
决策型: “制造业做数字化转型,第一阶段该选哪家供应商?”
-
方案型: “企业知识库大模型微调成本大约多少?”
-
避坑型: “某某行业在系统上线时常见问题有哪些?”
-
-
建立企业核心问答矩阵: 整理出行业内潜在客户在做采购决策前必问的 100~300 个场景化问题,作为后续所有内容生成的锚点。
第三阶段:重塑 RAG 友好型的高事实密度内容
大模型在调用外部检索生成答案时,更偏爱“即插即用”的模块化内容片段。如果一篇文章铺垫了800字空话才进入正题,在向量检索阶段就极易被过滤。
-
推行“结论先行(BLUF)”排版: 每个段落第一句话直接给事实或结论,随后展开论据,拒绝绕弯子。
-
增加高密度数据与对比图表: 大模型在做推荐时极其偏爱引用“带具体数字的对比维度”。多产出涵盖参数、功能、适用场景、价格梯度的客观对比表格。
-
结构化 FAQ 沉淀: 在所有核心产品页和行业方案页底部,嵌入直接对应真实搜索 Prompt 的问答模块,回答字数控制在 150~250 字以内,逻辑清晰闭环,让大模型检索模块能够一字不差地直接抓取作为回答素材。
第四阶段:全网“多源交叉验证(Cross-Validation)”生态布局
大模型推荐一个品牌,绝不会仅凭该品牌官网上的一面之词。如果官网自称“业内第一”,但全网其他平台毫无讨论,模型为了防范虚假信息,往往会放弃引用。
-
构建权威信源共识网: 推动企业真实案例、产品评测进驻第三方权威阵地(如行业垂直门户、权威技术社区、第三方测评机构)。
-
重视社区原生讨论生态: 在主流问答社区(如知乎)、专业技术论坛(如 CSDN、掘金)以及特定垂直圈子中,沉淀真实、深度的技术讨论与解决方案分析。当大模型在多方数据源中都能检索到相同的技术优势时,其置信度(Confidence Score)会大幅提升。
-
避免同质化机械发稿: 杜绝使用廉价垃圾站群去洗稿。低质且逻辑断层的劣质内容不仅无法提升权重,反而容易被模型安全机制打上“低质营销信息”的标签并降权。
第五阶段:建立 GEO 效果监测与迭代闭环
GEO 的见效周期一般需要 4 到 8 周。由于大模型输出具有动态性,效果评估不能靠“一次提问截图”,而需要建立系统化的多模型抽样机制。
-
核心监测指标:
-
引用率(Citation Rate): 在核心 Prompt 库的提问测试中,品牌在 AI 回答中被提及或作为信源出处的比例。
-
推荐顺位(Ranking Position): 当模型推荐 3~5 家供应商时,本品牌出现在第几位。
-
情感倾向与描述偏向(Sentiment & Context): AI 提及品牌时,贴上的标签是正面专业,还是存在错误理解。
-
-
跨模型差异化归因:
不同大模型的检索偏好存在客观差异。例如有的模型更倾向引用长文深度分析,有的模型高度依赖社群动态资讯,还有的模型极度依赖结构化代码标注。定期测试并记录各个主流平台的召回来源,反向修正第三、第四阶段的内容分发侧重点。
警惕企业转战 GEO 最容易踩的 3 个误区
-
企图用 AI 批量水文去“欺骗”AI。
传统 SEO 时代曾有人靠采集软件批量发文章取胜,但大语言模型本身就是内容审查的高手。缺乏独家业务数据、行业案例或真实经验的“拼凑型水文”,在内容向量化切片阶段就会被判定为低信息熵内容,根本进入不了召回候选池。
-
只做官网优化,忽略站外事实印证。
很多团队把官网改得非常漂亮,但站外没有任何第三方声音。大模型生成决策推荐非常依赖外部证据链。如果找不到独立第三方的客观交叉验证,模型极少会在对比型问题中首推该品牌。
-
盲目追求全平台覆盖,没有针对核心决策场景切入。
GEO 不是让品牌在所有娱乐、泛知识问答中露脸,而是要在“客户带着采购意图向 AI 咨询方案”的那一刻精准出现。先把精力聚焦在几十个与签单直接相关的核心决策场景上,比广泛铺量有价值得多。
搜索的入口变了,企业信息传递给客户的方式自然要跟着变。传统 SEO 依然有其技术底座价值,但单靠它已经无法支撑当下的流量增长。越早理清企业自身的结构化数据,建立高密度的专业内容与真实的第三方共识网络,就越能在 AI 掌握信息分发话语权的时代占据先机。